Описова статистика – це мистецтво перетворення неструктурованих даних на зрозумілу історію. Вона не робить припущень про те, що відбудеться в майбутньому, і не намагається передбачити весь всесвіт на основі невеликої вибірки. Натомість вона фокусується на тому, що знаходиться перед вами. Вона використовує числа для узагальнення набору даних, що полегшує виявлення закономірностей, пошук найпоширеніших значень та розуміння «центру» ваших даних.
Уявіть собі різницю між купою цегли та готовою стіною. Без розуміння матеріалу ви не зможете нічого збудувати.
Ця область всюди. Дослідники використовують її для перевірки експериментів. Маркетологи застосовують її розуміння демографії клієнтів. Лідери промисловості використовують її для відстеження показників ефективності. Однак перед тим, як використовувати ці методи, необхідно знати основи. Зокрема, потрібно розрізняти два основних типи даних та освоїти ключові метрики, які їх визначають.
Розуміння типів даних: якісні та кількісні
Не всю інформацію можна виміряти лінійкою чи калькулятором. Перший крок в описовій статистиці — визначити, чи є дані якісними чи кількісними.
Якісні дані (також відомі як категоріальні дані) відображають якість. Вони класифікують об’єкти. Вони відповідають питання «хто» чи «що», а чи не «скільки». Наприклад, колір вашого волосся, національність, релігія, улюблений смак морозива, марка мобільного телефону, який ви використовуєте, і т. д. Хоча ці характеристики не можна виразити в чистих числах, можна підрахувати кількість людей, які належать до кожної категорії.
Наприклад, уявіть співтовариство із 1000 осіб. Якщо ви запишете їхню національності (20 аргентинців, 25 венесуельців, 300 гватемальців, а решта — мексиканці), ви маєте справу з якісними даними. Ви не можете отримати нове громадянство, просто склавши «Мексику» та «Аргентину». Однак, ви можете розрахувати, який відсоток становить кожна група. Це допомагає класифікувати окремих осіб з різних груп і розуміти склад населення.
Кількісні дані, з іншого боку, є цифровою інформацією. Вони стосуються кількості та обсягу. Тут входить у гру математика. Наприклад, кількість робочих годин на тиждень, кількість кроків на день, кількість глядачів у театрі, час, проведений в інтернеті, і т. д. Оскільки це числа, з ними можна виконувати обчислення, такі як знаходження середніх значень та різниць.
Пошук середини: середнє арифметичне та медіана
Отримавши дані, часто хочете дізнатися, як виглядає «типове» значення. Два найчастіше використовувані інструменти – це середнє арифметичне та медіана.
Середнє арифметичне (або просто середнє) — це найпоширеніший захід центральної тенденції. Воно обчислюється шляхом підсумовування всіх значень у наборі даних та поділу на загальну кількість спостережень. У статистиці ми використовуємо символ x (x з рисою) для вибіркового середнього і символ µ (мю) для середнього значення генеральної сукупності.
Розглянемо конкретний приклад. Допустимо, ви хочете зважити 10 яблук. Їх ваги (у грамах): 225, 230, 242, 233, 267, 212, 222, 290, 233, 236.
Знайдіть середнє значення:
1. Сума: 2390 грамів.
2. Розділіть на 10 (кількість яблук).
Результат становив 239 грамів. Це число, що є центром групи.
Але середнє арифметичне не завжди є найкращим уявленням. Воно чутливе до екстремальних значень. Якби одне яблуко важило 500 г замість 290, середнє значення значно змінилося б, хоча більшість яблук все одно важили б близько 230 грамів. Тут входить у гру медіана.
Медіана – це значення, яке знаходиться посередині, коли всі точки даних упорядковані від найменшого до найбільшого. Вона стійкіша до викидів.
Використовуючи ті ж ваги яблук, упорядкуємо їх:
212, 222, 225, 230, 233, 233, 236, 242, 267, 290.
Кількість точок даних — парне число (10), тому немає єдиного середнього числа. Натомість ми беремо два середні значення (5-е та 6-е) і знаходимо їхнє середнє арифметичне. Тут обидва середні значення дорівнюють 233. Отже, медіанне значення становить 233 грами.
Якби яблук було 11, потрібно було б просто вибрати 6-е значення з відсортованого списку. Медіана показує центральне значення, незалежно від того, скільки важить найважче яблуко.
Вимірювання розкиду: стандартне відхилення
Знання центру – це лише половина справи. Вам також необхідно знати, наскільки широко розподілені дані. Всі яблука приблизно одного розміру, чи є значні відмінності?
Тут важливе стандартне відхилення. Це найбільш широко використовуваний захід мінливості. Воно показує, наскільки далеко кожна точка даних від середнього значення. Мале стандартне відхилення означає, що точки даних щільно згруповані навколо середнього значення. Велике стандартне відхилення означає, що вони широко розкидані.
Розглянемо два гіпотетичні набори даних з однаковим середнім та медіаною.
Набір даних A: 0, 200, 400
Набір даних B: 199, 200, 201
В обох випадках центр дорівнює 200, але розподіли зовсім різні. У наборі даних значення сильно відрізняються. У наборі B даних вони майже ідентичні. Стандартне відхилення набору даних A дорівнює 200, тоді як стандартне відхилення набору даних становить всього 1.
Цей показник допомагає зрозуміти узгодженість. В освіті клас із низьким стандартним відхиленням результатів тестів означає, що всі навчаються однаково. Велике стандартне відхилення означає, що існує велика різниця між високими та низькими результатами.
Розуміння відсотків
Відсотки часто неправильно розуміють. Це не відсотки від загальної суми. Навпаки, відсотки показують, який відсоток даних перебуває «нижче» певного значення.
Той факт, що ваша дитина важить на 90%, не означає, що ваша дитина важить 90% від чого-небудь. Це означає, що 90% дітей важать менше, ніж ця дитина. І лише 10% важать більше.
Давайте розрахуємо відсотки реального сценарію. Подайте математичний тест з оцінками від 1 до 100. Бали наступні:
20, 40, 45, 46, 48, 50, 51, 52, 53, 54, 60, 70, 80, 90, 92, 93, 94, 95, 96, 99.
Припустимо, ви хочете дізнатися відсотки учнів, які набрали 80 балів. Спочатку точно підрахуйте кількість людей, які набрали менше 80 балів. 13 людей набрали менше 80 балів.
Щоб знайти відсотки, можна використовувати просту формулу: (кількість значень/загальна кількість значень) * 100. Тут (13/20) * 100 = 65%.
Цей учень перебуває на 65%. Його оцінки були вищими, ніж у 65% класу. Це потужний спосіб порівняти результати окремої людини із групою, а не просто дивитися на сирі дані.
Візуалізація даних за допомогою гістограм
Числа корисні, але візуальні дані сприймаються швидше. Гістограма — це стовпчаста діаграма, що показує розподіл числових даних. На відміну від звичайних стовпчастих діаграм, які порівнюють різні категорії (наприклад, яблука та апельсини), гістограми групують безперервні дані в інтервали, які називаються «бінами» (кошиками).
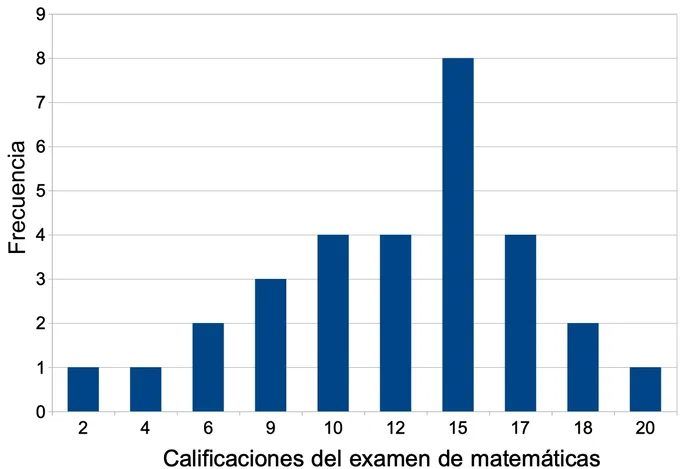
Горизонтальна вісь (вісь x) являє собою діапазон значень, наприклад, результати іспитів. Вертикальна вісь (вісь y) є частотою, тобто кількість разів, коли значення (або діапазон значень) зустрічається.
Подайте гістограму результатів математичного тесту класу з 30 учнів третього класу. Якщо 8 учнів здобули по 15 балів, над числом 15 з’явиться висока смуга. Подивившись на форму гістограми, ви можете швидко побачити, чи симетричні дані, мають вони лівосторонню або правосторонню асиметрію або дзвоноподібну форму.
Цей візуальний підхід допоможе вам виявити тенденції, які можуть бути приховані у таблиці чисел. Чи добрі загальні результати класу (висока смуга праворуч)? Або у вас є група учнів, які мають труднощі (висока смуга зліва)? Гістограми швидко виявляють розподіл ваших даних, забезпечуючи швидше розуміння та прийняття кращих рішень.
Описова статистика дозволяє вам припинити ворожити і почати спостерігати. Вона перетворює сирі вхідні дані на дієві висновки.
Пошук найбільш поширеного значення: Мода
При аналізі успішності у класі середні значення можуть давати повної картини. Іноді необхідно знати, що відбувається найчастіше. Саме це показує мода. Це значення, яке найчастіше зустрічається в даному наборі даних. На відміну від середнього значення, яке може бути спотворене викидами, мода вказує на найбільш типовий результат.
У конкретному випадку ми розглядаємо результати тестування 30 студентів. При погляді на гістограму чи вихідні дані виділяється один бал. Число 15 є модою. Йдеться не лише про високі бали. Це найпоширеніше значення. Конкретніше цей бал отримали вісім студентів. Це означає, що майже чверть класу набрала цю оцінку.
Чому це важливо для студентів та батьків? Коли велика група студентів отримує однаковий бал, це вказує на певний рівень складності або загальне нерозуміння матеріалу. Для тих, хто навчається все життя, розпізнавання моди допомагає зрозуміти де знаходяться «основні масиви даних». Вона показує, що є нормою у цій групі, а не просто середнє значення.
Мода — це значення, що найчастіше зустрічається. У цьому іспиті це 15 балів, оскільки 8 із 30 студентів досягли цього результату.
Визначення моди — це простий та потужний інструмент для аналізу тенденцій. Він відповідає питанням: «Який результат найімовірніший?». Найімовірніший бал на цьому іспиті – 15.